Outil de non-régression Exstream (composition & comparaison)
Génération exhaustive de cas de test et comparaison automatisée des sorties
Contexte
Dans un environnement finance/crédit, les évolutions documentaires sur les relevés Exstream devaient être sécurisées. Les recettes manuelles étaient coûteuses et incomplètes face à la combinatoire des discriminants (variantes, règles de composition, enseignes/produits). L'objectif était de garantir la non-régression d'une version à l'autre en automatisant à la fois la génération exhaustive des cas de test et la comparaison des rendus.
Objectifs
- Construire un outil de non-régression automatisé entre deux versions Exstream
- Générer exhaustivement les cas de test à partir des paramétrages éditiques (discriminants) et d'un modèle de flux
- Composer automatiquement les sorties multi-formats (AFP/PDF/HTML) pour chaque version à partir du même flux de test
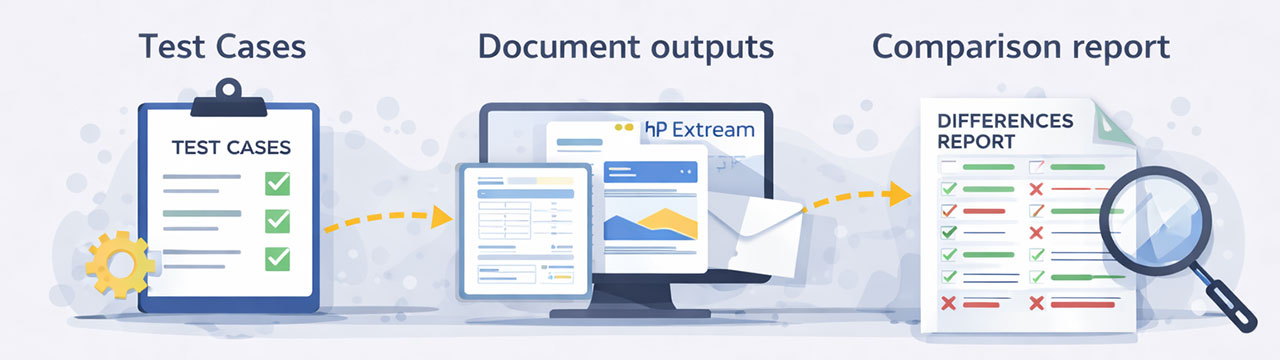
- Comparer en batch les rendus et produire un rapport des seules différences pour validation rapide
Approche
Développement d'un module Perl lisant l'ensemble des paramétrages éditiques afin d'identifier, via les discriminants, la liste complète des cas de test couvrant toutes les variantes de maquettes de relevés. Génération d'un flux de données de test à partir d'un modèle de référence : instanciation de toutes les occurrences en substituant systématiquement les valeurs des discriminants et des données d'identification (ex. nom de client remplacé par l'identifiant du cas de test) afin de rendre chaque rendu traçable. Exécution de la composition Exstream en mode batch pour une première version (baseline) et production des sorties AFP/PDF/HTML. Réutilisation du même flux avec la seconde version (contenant les évolutions) pour générer le second jeu de sorties. Mise en place d'un traitement de comparaison automatisé : soit par comparaison des HTML via un script Perl dédié, soit via HP Output Compare en batch afin de lister les écarts et produire un PDF de différences, consultable rapidement pour valider que les changements observés correspondent uniquement aux évolutions attendues. Réalisation des tests, livraison et rédaction de la documentation d'exploitation.
Livrables
- Outil Perl complet de génération de cas de test et de flux de données exhaustif
- Chaîne batch de composition Exstream multi-formats (AFP/PDF/HTML) sur deux versions
- Traitement de comparaison automatisé (HTML compare et/ou HP Output Compare batch) avec rapport PDF des différences
- Documentation + guide d'exploitation, tests et livraison
Resultats obtenus
- Couverture exhaustive des variantes grâce à la génération automatique des cas de test
- Réduction drastique du temps de recette et fiabilisation des non-régressions
- Comparaison centrée sur les différences via un rapport PDF lisible et rapide à valider
- Process industrialisé et reproductible à chaque évolution documentaire
